
Claude Code in deiner eigenen Web-App · Teil 15 von 16 der Serie
Teil 15: Ein lokales Modell als Gehirn
Lass das Claude Code einer Site mit einem Modell auf deinem Rechner denken: Ollama spricht die API von Anthropic, ein paar Umgebungsvariablen lenken die Sitzung dorthin, der Rest von Sitesmith bleibt. Mit einem ehrlichen Blick darauf, was ein kleines Modell auf einer CPU kann.
Claude Code in deiner eigenen Web-AppTeil 15 von 16
Auf dieser Seite
Quest-Ziele
- Ollama in Docker mit einem Kontext betreiben, der für Claude Code lang genug ist
- Eine Claude-Code-Sitzung auf die Anthropic-kompatible API von Ollama lenken und wissen, wofür jede Variable da ist
- Jeder Site ihr eigenes Gehirn geben, mit einem neuen Gespräch, wenn es wechselt
- Das Modell auf der Seite aus der Liste wählen, die Ollama hat
- Die Zeitlimits kennen, an die ein langsames Modell stößt, und wissen, was ein Modell auf einer CPU erwarten lässt
Vierzehn Teile lang hat das Claude Code jeder Site mit Claude gedacht, über dein Abo. Das ist das beste Gehirn, das Sitesmith haben kann, aber nicht das einzige, mit dem Claude Code sprechen kann. Claude Code schickt seine Anfragen an die Messages-API von Anthropic, und die Adresse dieser API ist eine Einstellung. Ollama, das Programm, das Sprachmodelle auf deinem eigenen Rechner laufen lässt, beantwortet dieselbe API. Lenk eine Sitzung dorthin, und Claude Code läuft wie gewohnt, mit seinen Werkzeugen, seinen Hooks und seinen Berechtigungsabfragen, während das Denken auf deinem Rechner passiert.
Dieser Teil macht daraus eine Wahl pro Site: eine Auswahl im Kopf der Site mit „Claude (your plan)“ und jedem Modell, das Ollama hat. Sitesmith selbst ändert sich kaum: eine Datei, die sich die Wahl merkt, ein paar Umgebungsvariablen für die Sitzung, eine Option mehr für Claude Code.
Eins vorweg, damit du weißt, wie viel Zeit du diesem Teil geben willst. Auf dem Rechner, auf dem diese Serie getestet wurde (16 CPU-Threads, keine Grafikkarte für das Modell), hat die Technik funktioniert: Der Auftrag kam beim Modell an, und seine Antwort kam zurück auf die Seite. Mit dem Modell selbst sah es anders aus: Es hat 26 Minuten an der ersten Anfrage von Claude Code gesessen, die meiste Zeit davon nur mit Lesen, und dann etwas beantwortet, das niemand gefragt hatte, ohne eine Datei anzufassen. Die letzten Abschnitte erklären, warum, und was du stattdessen ausprobieren kannst.
Wie Claude Code mit einem anderen Modell spricht
Claude Code ist ein Programm auf deinem Rechner, das Modell sitzt woanders. Dazwischen läuft die Messages-API: Claude Code schickt das Gespräch, seinen Systemprompt und die Beschreibungen seiner Werkzeuge an /v1/messages, und das Modell antwortet mit Text und Werkzeugaufrufen. Die Werkzeuge selbst führt Claude Code aus: Es liest die Datei, fragt nach der Berechtigung, startet die Hooks. Alles, worauf Sitesmith aufbaut, die Hooks, die Fragen, die Berechtigungsabfragen, der Plan-Modus, gehört also zu Claude Code und nicht zum Modell.
Seit Version 0.14 beantwortet auch Ollama diese API. Es übersetzt die Anfragen für seine Modelle und deren Antworten zurück, Denken und Werkzeugaufrufe eingeschlossen. Claude Code muss nicht wissen, dass es mit etwas anderem spricht. Es braucht eine andere Adresse und eine Handvoll Einstellungen, die sonst auf die Modelle von Anthropic zeigen würden.
Ollama in Docker
Ollama läuft auch ohne Docker, mit Installern für Linux, macOS und Windows. Docker hält es in einer Kiste, die du wegwerfen kannst, und so wurde es hier getestet:
$ docker run -d --name ollama -p 127.0.0.1:11434:11434 -e OLLAMA_CONTEXT_LENGTH=32768 -e OLLAMA_FLASH_ATTENTION=1 -e OLLAMA_KV_CACHE_TYPE=q8_0 -v ollama:/root/.ollama ollama/ollama42e31ac0de4a…$ curl -s localhost:11434/api/version{"version":"0.40.16"}$ docker exec ollama ollama pull qwen3:1.7b# …success$ curl -s localhost:11434/api/show -d '{"model":"qwen3:1.7b"}'# … (only the capabilities)["completion","tools","thinking"]
Die Optionen von docker run, eine nach der anderen:
-p 127.0.0.1:11434:11434: der Port nur auf diesem Rechner. Ollama hat keine Anmeldung, und wer den Port erreicht, kann deine Modelle benutzen.OLLAMA_CONTEXT_LENGTH=32768: wie viele Tokens ein Modell auf einmal halten darf. Mehr zu dieser Zahl gleich unten; sie ist die wichtigste Einstellung von allen.OLLAMA_FLASH_ATTENTION=1undOLLAMA_KV_CACHE_TYPE=q8_0: Der Speicher für den Kontext, der KV-Cache, wird mit 8 statt 16 Bit gehalten, etwa halb so groß. Das macht Ollama nur mit eingeschalteter Flash Attention. Ein langer Kontext kostet Speicher, und so halbiert sich die Rechnung.-v ollama:/root/.ollama: Die Modelle liegen in einem Docker-Volume und überleben so einen neuen Container.
/api/version zeigt, dass Ollama antwortet; jede Version ab 0.14 hat die Anthropic-API, und hier war es 0.40.16. ollama pull, im Container ausgeführt, lädt das Modell herunter. qwen3:1.7b ist ein kleines, mit 1,7 Milliarden Parametern, gewählt, weil dieser Rechner etwa 6 GB Speicher frei hatte. /api/show beschreibt ein Modell; von seiner langen Antwort stehen hier nur die Fähigkeiten. Die entscheidende ist tools. Claude Code erledigt seine ganze Arbeit über Werkzeuge, eine Datei lesen, eine schreiben, einen Befehl ausführen, und ein Modell ohne Werkzeugunterstützung kann nur reden.
Die Falle mit der Kontextlänge
Ein Sprachmodell liest bei jeder Antwort das ganze Gespräch, und die Kontextlänge ist, wie viel davon hineinpasst. Ollama wählt den Standardwert nach dem Speicher deiner Grafikkarte: unter 24 GB VRAM, und damit auch auf einem Rechner ohne Grafikkarte, sind das 4k Tokens.
Die erste Anfrage von Claude Code war im Test 19.602 Tokens lang, fast alles davon vor dem ersten Wort des eigentlichen Auftrags: sein Systemprompt und die Beschreibungen seiner Werkzeuge. Mit dem Standardwert passen vier Fünftel davon nicht hinein. Ollama weist so eine Anfrage nicht ab; es kürzt sie auf das, was passt, und das Modell macht sich mit nur einem Teil der Anweisungen und Werkzeugbeschreibungen an die Arbeit, die Claude Code geschickt hat. Claude Code erfährt davon nichts, und auf der Seite siehst du nur ein Modell, das sich seltsam verhält.
Die Dokumentation von Ollama verlangt für Agents und Coding-Werkzeuge mindestens 64k Tokens, und die solltest du nehmen, wenn dein Rechner den Speicher hat: Der Kontext braucht Speicher zusätzlich zum Modell, und umso mehr, je länger er ist. Dieser Rechner hatte Platz für 32k, und das reicht für den Anfang. Die erste Anfrage passt hinein, mit rund 13.000 Tokens Luft, aber ein Gespräch füllt das schnell: Jede Datei, die Claude Code liest, kommt dazu. Mit genug Speicher schreibst du im docker run oben 65536.
Der Anthropic-Endpunkt von Ollama, von Hand ausprobiert:
$ curl -s localhost:11434/v1/messages -H 'content-type: application/json' -H 'x-api-key: ollama' -H 'anthropic-version: 2023-06-01' -d '{"model":"qwen3:1.7b","max_tokens":200,"messages":[{"role":"user","content":"Say hello in five words."}]}'{"id":"msg_6673e250b63dabbbc663a282","type":"message","role":"assistant","model":"qwen3:1.7b","content":[{"type":"thinking","thinking":"Okay, the user asked to say hello in five words. …
Das hat 7,9 Sekunden gedauert, und die Antwort begann mit einem Denkblock: qwen3 denkt nach, bevor es antwortet, und Ollama reicht das Denken so weiter, wie es bei Claude ankommt. Achte auf die Adresse. Die API liegt unter /v1/messages, und diesen Teil hängt Claude Code selbst an. Claude Code bekommt also die Wurzel, http://127.0.0.1:11434, ohne /v1.
Ein Gehirn pro Site
Die Wahl gehört zu einer Site: Eine Site baust du vielleicht mit Claude, eine andere mit einem lokalen Modell, das du ausprobieren willst. Zuerst die Typen, oben in shared/types.ts. Ein Brain ist entweder dein Abo oder ein lokales Modell mit seinem Namen. Eine Site trägt ihr Gehirn, und LocalModels beantwortet die Frage, welche Modelle es gibt (Config bleibt, wie es ist):
/** What the server and the page both know about. */

/** What Claude Code thinks with: your Claude plan, or a model on your own machine (through Ollama). */
export type Brain = { kind: 'plan' } | { kind: 'local'; model: string };

/** A site: one folder in sites/, which Claude Code builds. */
export interface Site {
  /** the folder's name: also the site's address in the page and in the preview */
  name: string;
  title: string;
  description: string;
  created: number;
  /** whether it has an index.html yet */
  built: boolean;
  brain: Brain;
}

export interface NewSite {
  name: string;
  title: string;
  description: string;
}

export interface Config {
  /** the preview server's port: the sites are shown from there, never from the page's own address */
  previewPort: number;
  /** whether tmux was found: without it there are no sessions */
  terminals: boolean;
  /** whether node-pty was found: without it the page can't show the sessions */
  pty: boolean;
}

/** The models Ollama has, or why there are none. */
export interface LocalModels {
  models: string[];
  error?: string;
}
Die Wahl liegt im Ordner der Site, neben site.json: .sitesmith/brain.json. Ergänze in server/sites.ts den Typ-Import um Brain und den Namen der Datei unter den anderen:
/** Sitesmith's own files in a site's folder. */
export const OWN = '.sitesmith';
const META = `${OWN}/site.json`;
const BRAIN = `${OWN}/brain.json`;
Dann ersetz read und füg darunter drei Methoden an:
read(name: string): Site | null {
  if (!NAME.test(name)) return null;
  try {
    const meta = JSON.parse(fs.readFileSync(path.join(this.dir(name), META), 'utf8')) as Omit<Site, 'name' | 'built' | 'brain'>;
    return { ...meta, name, built: fs.existsSync(path.join(this.dir(name), 'index.html')), brain: this.brain(name) };
  } catch { return null; }
}

/** What the site's Claude Code thinks with: your plan, unless a local model was chosen. */
brain(name: string): Brain {
  try {
    const b = JSON.parse(fs.readFileSync(path.join(this.dir(name), BRAIN), 'utf8')) as Brain;
    if (b.kind === 'local' && typeof b.model === 'string' && b.model) return { kind: 'local', model: b.model };
  } catch { /* none chosen */ }
  return { kind: 'plan' };
}

/** A brain from what the page sent, checked: a local model needs a plain name. */
brainFrom(input: Partial<Brain>): Brain {
  if (input.kind !== 'local') return { kind: 'plan' };
  const model = String((input as { model?: string }).model ?? '').trim();
  if (!/^[\w.:/-]{1,100}$/.test(model)) throw new HttpError(400, 'Pick a local model.');
  return { kind: 'local', model };
}

setBrain(name: string, brain: Brain) {
  fs.writeFileSync(path.join(this.dir(name), BRAIN), `${JSON.stringify(brain)}\n`);
}
brain liest die Datei und fällt bei allem anderen auf das Abo zurück: keine Datei, eine kaputte, ein Modell ohne Namen. Eine Site, für die niemand gewählt hat, und das sind bisher alle, bleibt bei deinem Abo. brainFrom nimmt, was die Seite schickt, und prüft es; ein falscher Name ist eine 400. Der Name eines Modells darf nur die Zeichen enthalten, die Namen bei Ollama haben (Buchstaben, Ziffern, _ . : / -), weil er als Argument von Claude Code und in dessen Umgebung landet. setBrain schreibt nur die Datei; die Route weiter unten prüft zuerst und schreibt zuletzt. Die Ordnerüberwachung aus Teil 2 übergeht .sitesmith/, das Schreiben der Datei sieht also nicht wie eine Änderung an der Site aus.
Ein Wechsel beginnt ein neues Gespräch
Das Gehirn einer Sitzung steht fest, sobald sie startet: Die Variablen und die Option --model bekommt Claude Code, wenn tmux es startet. Ein Wechsel muss die Sitzung also beenden, und der nächste Auftrag startet eine neue mit dem neuen Gehirn. In server/agent.ts bekommt die Klasse eine Menge der Sites, deren nächste Sitzung von vorn beginnt:
private sites = new Map<string, SiteAgent>();
private pending = new Map<string, Pending>();
/** sites whose next session starts a new conversation (their brain changed) */
private fresh = new Set<string>();
Füg diese Methode in die Klasse ein, über stop:
/**
 * Another brain for the site: it takes effect in a new session, with a new conversation (a long
 * conversation of one model is a poor start for another). Not in the middle of a run.
 */
async brainChanged(t: Target) {
  if (this.active(t.name) || this.site(t.name).ask) throw new Error('Claude Code is working on this site. Switch when it is done.');
  this.fresh.add(t.name);
  await this.terminals.end(t);
}
Und ersetz deliverNext:
private async deliverNext(name: string, s: SiteAgent) {
  const job = s.queue[0];
  if (!job) return;
  await this.terminals.poll();
  const term = this.terminals.get(name);
  // a conversation continues, unless the site's brain changed since
  const resume = this.terminals.hasConversation(job.target.dir) && !this.fresh.has(name);
  try {
    if (!term) await this.terminals.start(job.target, { prompt: COMMAND, resume, plan: job.plan });
    else if (!term.claude) await this.terminals.respawn(job.target, { prompt: COMMAND, resume, plan: job.plan });
    else {
      if (this.busy(name) || !(await this.terminals.atEmptyPrompt(job.target))) return;
      // it may have been taken while we looked
      if (s.queue[0] !== job) return;
      // plan mode for a plan first, and out of it for everything else
      if (!(await this.terminals.setMode(job.target, job.plan ? 'plan' : 'acceptEdits'))) {
        throw new Error(`Claude Code did not switch to ${job.plan ? 'plan mode' : 'accepting edits'}: look in the terminal.`);
      }
      await this.terminals.type(job.target, COMMAND);
    }
  } catch (err) {
    s.queue.shift();
    s.run = job;
    this.end(name, 'failed', (err as Error).message);
    return;
  }
  s.queue.shift();
  s.run = job;
  if (!term?.claude) this.fresh.delete(name);
  job.status = 'starting';
  job.started = job.sentAt = Date.now();
  this.changed(name);
}
Zwei Zeilen sind darin neu. resume hat das letzte Gespräch des Ordners fortgesetzt, wann immer es eines gab (Teil 5); nach einem Wechsel tut es das nicht. Und sobald eine neue Sitzung gestartet ist, über start oder respawn und nicht durch Tippen in eine laufende, verlässt die Site die Menge wieder, und die folgenden Aufträge setzen das neue Gespräch fort wie bisher.
Warum nicht das alte Gespräch mit dem neuen Modell fortsetzen? Weil es für das andere ein schlechter Anfang ist. Ein Gespräch eines ganzen Nachmittags mit Claude kann länger sein als der gesamte Kontext eines lokalen Modells, es würde also gar nicht hineinpassen. Und umgekehrt würde Claude dort weitermachen, wo das kleine Modell irgendetwas angestellt hat. Der eigentliche Zustand einer Site sind ohnehin ihre Dateien: Ein neues Gespräch beginnt mit dem Ordner, wie er ist, und mit der CLAUDE.md aus Teil 2, die jedem Modell sagt, was der Ordner ist.
brainChanged lehnt ab, solange Claude Code an der Site arbeitet oder auf der Seite auf eine Antwort wartet, denn das Beenden der Sitzung würde einen Lauf mittendrin abschneiden. Startest du die Sitzung nach einem Wechsel von Hand aus dem Kopf der Site, gibt dir „Start Claude Code“ ebenfalls ein neues Gespräch. „Continue last conversation“ nimmt das alte mit dem neuen Gehirn wieder auf; das ist dann deine Entscheidung.
Optionen und Routen
In server/main.ts kommen unter DATA zwei Optionen zu den anderen, mit einer kleinen Funktion für die Adresse von Ollama:
/** OLLAMA_HOST as Ollama reads it ("0.0.0.0", "box:11434", "https://box"), as an address to call */
function ollamaUrl(host = '127.0.0.1:11434') {
  const url = new URL(/^https?:\/\//.test(host) ? host : `http://${host}`);
  // the address Ollama listens on for everyone, called here
  if (url.hostname === '0.0.0.0') url.hostname = '127.0.0.1';
  if (!url.port && url.protocol === 'http:') url.port = '11434';
  return url.origin;
}
/** Ollama, for sites on a local model */
const OLLAMA = option('--ollama', ollamaUrl(process.env.OLLAMA_HOST || undefined));
/** the context length Ollama gives its models (OLLAMA_CONTEXT_LENGTH): Claude Code needs to know it */
const LOCAL_CONTEXT = Number(option('--local-context', '65536'));

const sites = new Sites(path.resolve(option('--sites', path.join(APP, 'sites'))));
const config: Config = { previewPort: PREVIEW_PORT, terminals: false, pty: false };
--ollama ist die Adresse von Ollama, so wie Claude Code sie benutzen soll: die Wurzel, ohne /v1. Ohne die Option nimmt Sitesmith OLLAMA_HOST, die Variable, die auch die Kommandozeile von Ollama liest, und sonst 127.0.0.1:11434. ollamaUrl liest diese Variable so, wie Ollama es tut: Sie kann ein bloßer Host sein, ein Host mit Port oder eine ganze Adresse. Fehlt das Schema, heißt das http, fehlt der Port, 11434 (eine https-Adresse behält ihren eigenen Standardport), und 0.0.0.0, mit dem Ollama auf allen Netzwerkadressen lauscht, wird über 127.0.0.1 angesprochen. --local-context ist die Kontextlänge, die du Ollama gegeben hast. Sitesmith liest sie nicht bei Ollama aus, du gibst also dieselbe Zahl an. Ihr Standardwert, 65.536, sind die 64k, die die Dokumentation verlangt. Ergänze den Typ-Import um Brain und LocalModels und die Aufrufzeile ganz oben in der Datei um die zwei Optionen: [--ollama URL] [--local-context 65536].
Die Terminals erfahren beides gleich nach ihrer Erzeugung, und target, mit dem jede Route eine Site findet, reicht jetzt auch ihr Gehirn weiter. localModels fragt Ollama nach seinen Modellen (/api/tags, was ollama list zeigt), mit drei Sekunden Geduld:
const terminals = new Terminals(APP, broadcast);
terminals.setOllama(OLLAMA, LOCAL_CONTEXT);
await terminals.init();
config.terminals = terminals.available;
config.pty = terminals.canAttach;
const agent = new Agent(APP, DATA, terminals, broadcast, () => clients.size);

/** A site's name and folder: what the terminals need, after checking the site exists. */
function target(name: string): Target {
  const site = sites.get(name);
  return { name: site.name, dir: sites.dir(site.name), brain: site.brain };
}

/** The models Ollama has: its /api/tags. */
async function localModels(): Promise<LocalModels> {
  try {
    const res = await fetch(`${OLLAMA}/api/tags`, { signal: AbortSignal.timeout(3000) });
    const data = await res.json() as { models?: { name: string }[] };
    return { models: (data.models ?? []).map((m) => m.name).sort() };
  } catch {
    return { models: [], error: `Ollama does not answer at ${OLLAMA}.` };
  }
}
Zwei Routen kommen in die Liste, nach GET /api/sites/…:
// what a site's Claude Code thinks with
['GET', /^\/api\/local-models$/, async (_req, res) => send(res, 200, await localModels())],
['PUT', /^\/api\/sites\/([^/]+)\/brain$/, async (req, res, m) => {
  const t = target(m[1]);
  const brain = sites.brainFrom(await readJson<Brain>(req));
  try { await agent.brainChanged(t); } catch (err) { throw new HttpError(409, (err as Error).message); }
  sites.setBrain(t.name, brain);
  broadcast({ type: 'sites', sites: sites.list() });
  send(res, 200, sites.get(t.name));
}],
Die PUT-Route prüft in einer Reihenfolge, die nichts halb erledigt zurücklässt. Zuerst brainFrom: Ein falscher Modellname ist eine 400, bevor irgendetwas passiert. Dann brainChanged: Ist Claude Code beschäftigt, ändert sich nichts, und die Seite bekommt eine 409 mit dem Grund; sonst endet die Sitzung. Erst dann wird die Datei geschrieben, und jede offene Seite bekommt die neue Liste der Sites, mit dem Gehirn darin.
Die Umgebung der Sitzung
Alles, was das lokale Modell braucht, erreicht Claude Code über seine Sitzung. Ergänze in server/terminals.ts den Typ-Import um Brain, und gib dem Ziel und den Startoptionen ein Gehirn:
export interface Target { name: string; dir: string; brain?: Brain }
/** How a session starts: with a first message, continuing the last conversation, in plan mode. */
export interface StartOptions { prompt?: string; resume?: boolean; plan?: boolean; brain?: Brain }
Die Klasse merkt sich die Adresse von Ollama und die Kontextlänge neben den Hooks:
private hooks: { settings: string; data: string } | null = null;
/** where Ollama listens, for sessions on a local model, and the context length it gives them */
private ollama = { url: 'http://127.0.0.1:11434', context: 65536 };
available = false;
Ersetz env, mit setOllama darüber:
setOllama(url: string, context: number) {
  this.ollama = { url, context };
}

/**
 * The session's environment: which site its hooks report for and where they find the server;
 * on a local model also where Claude Code sends its requests instead of Anthropic's API. The
 * core of what `ollama launch claude` sets: every model name Claude Code uses (its aliases, the
 * subagents') means the local model, and no API key is sent.
 */
private env(t: Target) {
  const vars: Record<string, string> = {};
  if (this.hooks) Object.assign(vars, { SITESMITH_SITE: t.name, SITESMITH_DATA: this.hooks.data });
  if (t.brain?.kind === 'local') {
    const model = t.brain.model;
    Object.assign(vars, {
      ANTHROPIC_BASE_URL: this.ollama.url,
      ANTHROPIC_AUTH_TOKEN: 'ollama',
      ANTHROPIC_API_KEY: '',
      // the endpoint above wins over one in your settings files
      CLAUDE_CODE_PROVIDER_MANAGED_BY_HOST: '1',
      ANTHROPIC_DEFAULT_OPUS_MODEL: model,
      ANTHROPIC_DEFAULT_SONNET_MODEL: model,
      ANTHROPIC_DEFAULT_HAIKU_MODEL: model,
      CLAUDE_CODE_SUBAGENT_MODEL: model,
      // Claude Code knows the context of its own models only: it would assume 1M tokens and
      // compact the conversation far too late
      CLAUDE_CODE_MAX_CONTEXT_TOKENS: String(this.ollama.context),
      // Ollama has no server-side checks for auto mode
      CLAUDE_CODE_AUTO_MODE_SERVER: '0',
      // a model on a CPU may read for many minutes before its first word: an hour for the
      // answer to begin (instead of 10 minutes), and no 5-minute limit on a pause within it
      API_TIMEOUT_MS: '3600000',
      API_FORCE_IDLE_TIMEOUT: '0',
    });
  }
  return Object.entries(vars).flatMap(([k, v]) => ['-e', `${k}=${v}`]);
}
Bisher hat env der Sitzung die zwei Variablen der Hooks gegeben (Teil 6). Jetzt sammelt es sie in einem Objekt, fügt die des lokalen Modells hinzu, wenn die Site eins hat, und macht aus allen die Paare -e NAME=Wert für tmux. In Teil 3 hat tmux.conf ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN und ANTHROPIC_API_KEY aus jeder Sitzung genommen, damit nichts deine Sitzungen aus Versehen woandershin schickt. Hier kommen sie zurück, mit Absicht, für eine Sitzung. Eine nach der anderen:
ANTHROPIC_BASE_URL: wohin Claude Code seine Anfragen schickt. Die Wurzeladresse von Ollama;/v1/messageshängt Claude Code an.ANTHROPIC_AUTH_TOKEN=ollama: ein Token, das Claude Code alsAuthorization: Bearer ollamamitschickt. Ollama auf deinem Rechner prüft es nicht, aber mit einem gesetzten Token arbeitet Claude Code damit statt mit deiner Claude-Anmeldung.ANTHROPIC_API_KEY, leer: kein API-Schlüssel, egal woher einer kommen könnte. Die Dokumentation von Ollama setzt ihn genauso leer.CLAUDE_CODE_PROVIDER_MANAGED_BY_HOST=1: sagt, dass das Programm, das Claude Code gestartet hat, bestimmt, wohin seine Anfragen gehen. Claude Code übergeht dann Adressen und Zugangsdaten in Einstellungsdateien, einenv-Block in deiner~/.claude/settings.jsonkann diese Sitzung also nicht woandershin schicken. Ohne die Variable gewinnen Einstellungsdateien gegen die Umgebung, wovor die Dokumentation von Ollama warnt.ANTHROPIC_DEFAULT_OPUS_MODEL,…_SONNET_MODEL,…_HAIKU_MODEL: wofür die Kurznamenopus,sonnetundhaikustehen. Claude Code benutzt mehr als ein Modell: Haiku erledigt Arbeit im Hintergrund, und die Kurznamen sind, was/modelanbietet. Jeder davon würde Ollama nach einem Claude-Modell fragen, das es nicht hat. Jetzt meinen alle das lokale Modell.CLAUDE_CODE_SUBAGENT_MODEL: das Modell der Subagents, der Helfer, die Claude Code für eine Nebenaufgabe startet. Dasselbe lokale Modell.CLAUDE_CODE_MAX_CONTEXT_TOKENS: mit wie viel Kontext Claude Code rechnen darf. Es kennt nur die Fenster seiner eigenen Modelle, und bei diesem hier hat es gewarnt:Model "qwen3:1.7b" isn't recognized · context assumed to be 1m tokens. Claude Code verdichtet ein Gespräch, fasst es zusammen, wenn es sich dem Fenster nähert. Rechnet es mit einer Million Tokens, täte es das erst lange nachdem Ollama angefangen hat wegzulassen, was nicht hineinpasst. Mit der echten Zahl verdichtet es rechtzeitig. Deshalb muss--local-contextzuOLLAMA_CONTEXT_LENGTHpassen.CLAUDE_CODE_AUTO_MODE_SERVER=0: Im Auto-Modus, wo Claude Code ihn anbietet, entscheidet eine Prüfung, welche Aktionen ohne Rückfrage laufen. Bei der API von Anthropic lässt Claude Code sie vom Server prüfen. Ollama hat keine solche Prüfung, also schickt Claude Code mit0eigene Prüfanfragen, die jetzt wie alles andere an das lokale Modell gehen. Sitesmith arbeitet im Accept-Edits-Modus, das spielt also nur eine Rolle, wenn du selbst in den Auto-Modus wechselst.API_TIMEOUT_MSundAPI_FORCE_IDLE_TIMEOUT: die Zeitlimits, gleich unten.
Das ist auch der Kern dessen, was ollama launch claude setzt; mehr zu diesem Befehl am Ende.
Die Zeitlimits
Claude Code gibt jeder Anfrage zehn Minuten, bis die Antwort beginnt (genau genommen, bis die Header der Antwort da sind). Für Claude ist das großzügig. Ein Modell auf einer CPU muss aber erst die ganze Anfrage lesen, und Ollama schickt nichts, bevor es damit fertig ist. API_TIMEOUT_MS=3600000 gibt ihm eine Stunde. API_FORCE_IDLE_TIMEOUT=0 schaltet eine zweite Grenze ab: Sobald eine Antwort fließt, bricht Claude Code sie nach fünf Minuten ohne ein Byte ab, bei jedem Endpunkt, der nicht der von Anthropic ist, und ein langsames Modell kann so lange Pause machen. Claude Code hat noch weitere Wächter für stumme Verbindungen, die diese Variable nicht berührt. Beide Werte sind für langsame Rechner gedacht, und der Test unten zeigt, wie langsam das sein kann.
Das Modell beim Namen
Ersetz command, start und respawn:
/**
 * What the session runs: Claude Code in a login shell, and when it exits, an interactive shell in
 * the folder, so the session stays open. The shell gets the program and its arguments as "$0"
 * and "$@", so no argument is ever parsed by the shell.
 */
private command(opts: StartOptions) {
  return [SHELL, '-lic', '"$0" "$@"; exec "$SHELL" -i', CLAUDE,
    // file edits in the site's folder go ahead, commands still ask; or plan mode for a plan first
    '--permission-mode', opts.plan ? 'plan' : 'acceptEdits',
    // a local model by its name in Ollama
    ...(opts.brain?.kind === 'local' ? ['--model', opts.brain.model] : []),
    // the hooks, on top of your own settings
    ...(this.hooks ? ['--settings', this.hooks.settings] : []),
    ...(opts.resume ? ['--continue'] : []),
    ...(opts.prompt ? [opts.prompt] : [])];
}

/** Starts Claude Code in a site's session: fresh, or continuing the folder's last conversation. */
async start(t: Target, opts: StartOptions = {}) {
  if (this.states.has(t.name)) return;
  await this.tmux('new-session', '-d', '-s', t.name, '-x', '120', '-y', '36', '-c', t.dir, ...this.env(t), ...this.command({ ...opts, brain: t.brain }))
    .catch((err: Error) => { if (!/duplicate session/.test(err.message)) throw err; });
  await this.poll();
}

/** Claude Code again, in place of the shell it left behind. */
async respawn(t: Target, opts: StartOptions = {}) {
  await this.tmux('respawn-pane', '-k', '-t', pane(t.name), '-c', t.dir, ...this.env(t), ...this.command({ ...opts, brain: t.brain }));
  await this.poll();
}
--model setzt das Hauptmodell mit seinem Namen bei Ollama. Claude Code kennt den Namen nicht, und das muss es auch nicht: Es schickt ihn, wie er ist, und genau darum ging es in der Warnung oben. start und respawn reichen das Gehirn des Ziels an command weiter; die Umgebung kommt wie bisher aus env(t).
Die Auswahl
Leg src/brainPicker.ts an:
import { api } from './api.ts';
import { h } from './dom.ts';
import type { Brain, LocalModels, Site } from '../shared/types.ts';

/** the plan's option: a value no model's name can be */
const PLAN = '';

/**
 * What the site's Claude Code thinks with: your Claude plan, or one of the models Ollama has.
 * A switch ends the session; the next request starts it with the new brain and a new conversation.
 */
export class BrainPicker {
  readonly el: HTMLElement;
  private site: string;
  private select = h('select', { 'aria-label': 'What Claude Code thinks with' });
  private msg = h('span', { class: 'hint bad', 'aria-live': 'polite' });
  private brain: Brain = { kind: 'plan' };
  private models: string[] = [];

  constructor(site: string) {
    this.site = site;
    this.select.onchange = () => void this.choose();
    this.select.onfocus = () => void this.load();
    this.el = h('label', { class: 'brain' }, this.select, this.msg);
    void this.load();
  }

  /** Ollama's models, asked again whenever the list is opened (you may have pulled one since). */
  private async load() {
    const r = await api<LocalModels>('GET', '/api/local-models').catch(() => ({ models: [], error: 'No answer.' }) as LocalModels);
    this.select.title = r.error ?? '';
    // the same list again: leave the open list alone
    if (r.models.join() === this.models.join()) return;
    this.models = r.models;
    this.render();
  }

  update(site: Site | null) {
    if (!site || (JSON.stringify(site.brain) === JSON.stringify(this.brain) && this.select.options.length)) return;
    this.brain = site.brain;
    this.render();
  }

  private render() {
    const current = this.brain.kind === 'local' ? this.brain.model : PLAN;
    const models = [...new Set([...this.models, ...(this.brain.kind === 'local' ? [this.brain.model] : [])])];
    this.select.replaceChildren(
      h('option', { value: PLAN }, 'Claude (your plan)'),
      ...models.map((m) => h('option', { value: m }, `Local: ${m}`)));
    this.select.value = current;
  }

  private async choose() {
    const value = this.select.value;
    this.msg.textContent = '';
    if (!confirm('Switch the brain? Claude Code restarts with it, in a new conversation.')) { this.render(); return; }
    const brain: Brain = value === PLAN ? { kind: 'plan' } : { kind: 'local', model: value };
    try { await api('PUT', `/api/sites/${this.site}/brain`, brain); } catch (err) {
      this.msg.textContent = (err as Error).message;
      this.render();
    }
  }
}
Ein schlichtes select: zuerst „Claude (your plan)“, dann „Local: …“ für jedes Modell, das Ollama hat. Die Option für das Abo hat den leeren Wert, den kein Modellname haben kann. Die Liste wird jedes Mal neu geholt, wenn das Select den Fokus bekommt; ein Modell, das du gerade heruntergeladen hast, erscheint also ohne Neuladen der Seite. Ist die Liste dieselbe wie vorher, bleiben die Optionen, wie sie sind, ebenso, wenn sich das Gehirn der Site nicht geändert hat, damit eine Liste, die du gerade aufgeklappt hast, nicht unter deinem Zeiger neu gebaut wird. Das aktuelle Modell der Site bleibt in der Liste, auch wenn Ollama nicht antwortet, damit das Select nie eine Wahl zeigt, die nicht stimmt. Ist Ollama nicht erreichbar, steht der Grund im Tooltip des Selects.
Ein Wechsel fragt erst nach, weil er die Sitzung beendet. Lehnt der Server ab, erscheint die Meldung neben dem Select, und es springt zurück. Bei Erfolg tut die Auswahl selbst nichts: Der Server schickt jeder Seite die neue Liste der Sites, und update stellt das Select danach ein.
Die Liste enthält jedes Modell, das Ollama hat, auch solche, die keine Werkzeuge benutzen können, zum Beispiel ein Embedding-Modell. Nimm eins mit tools unter seinen Fähigkeiten.
Importier in src/sitePage.ts BrainPicker, leg unter session ein Feld private brain: BrainPicker; an und setz die Auswahl in den Kopf, vor die Bedienelemente der Sitzung:
constructor(name: string, config: Config) {
  this.name = name;
  this.config = config;
  this.session = new SessionControls(name, config.terminals);
  this.brain = new BrainPicker(name);
  this.terminal = new TerminalView(name, config.pty);
  const attachments = new Attachments(name, this.previewUrl);
  this.request = new RequestBox(name, attachments);
  this.agent = new AgentPanel(name);
  this.tabs = {
    preview: h('button', { type: 'button', class: 'tab', role: 'tab', onclick: () => this.show('preview') }, 'Preview'),
    terminal: h('button', { type: 'button', class: 'tab', role: 'tab', onclick: () => this.show('terminal') }, 'Terminal'),
  };
  this.el = h('section', { class: 'site-page' },
    h('header', { class: 'site-head' },
      h('div', { class: 'site-head-text' }, this.heading, this.about),
      this.brain.el,
      this.session.el,
      h('a', { class: 'button small', href: this.previewUrl, target: '_blank', rel: 'noopener' }, 'Open in a new tab')),
    h('div', { class: 'site-body' },
      h('div', { class: 'work' }, this.request.el, this.agent.el),
      h('div', { class: 'view' },
        h('div', { class: 'tabs', role: 'tablist' }, this.tabs.preview, this.tabs.terminal),
        this.preview, this.terminal.el)));
  this.show('preview');
  dropTarget(this.el, (files) => void attachments.add(files));
}
Und in update eine Zeile am Ende:
/** The list of sites changed (or arrived). */
update(sites: Site[]) {
  const site = sites.find((s) => s.name === this.name) ?? null;
  const wasBuilt = this.site?.built;
  this.site = site;
  this.heading.textContent = site?.title ?? this.name;
  this.about.textContent = site ? site.description : 'There is no site of this name.';
  this.frame.hidden = !site?.built;
  this.empty.hidden = Boolean(site?.built);
  if (site?.built && !wasBuilt) this.frame.src = this.previewUrl;
  this.request.update(site, isLive(this.agentState?.run));
  this.brain.update(site);
}
Der Test
Starte den Server mit der Kontextlänge, die du Ollama gegeben hast. Bei 65.536 kannst du die Option weglassen; der Test lief mit 32k:
$ npm run server -- --local-context 32768Die Test-Site war mit Absicht winzig, „Hello Local“, mit einem einzigen Auftrag: Create index.html with a heading Hello from a local model and one short paragraph. Bevor er losging, wurde die Site auf „Local: qwen3:1.7b“ umgestellt. Das hat ihre Sitzung bekommen:
$ tmux -L sitesmith show-environment -t =tiny-localANTHROPIC_API_KEY=ANTHROPIC_AUTH_TOKEN=ollamaANTHROPIC_BASE_URL=http://127.0.0.1:11434ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3:1.7bANTHROPIC_DEFAULT_OPUS_MODEL=qwen3:1.7bANTHROPIC_DEFAULT_SONNET_MODEL=qwen3:1.7bAPI_FORCE_IDLE_TIMEOUT=0API_TIMEOUT_MS=3600000CLAUDE_CODE_AUTO_MODE_SERVER=0CLAUDE_CODE_MAX_CONTEXT_TOKENS=32768CLAUDE_CODE_PROVIDER_MANAGED_BY_HOST=1CLAUDE_CODE_SUBAGENT_MODEL=qwen3:1.7b# … (SITESMITH_DATA, SITESMITH_SITE)
Alle Variablen aus env, der API-Schlüssel leer. Das Banner von Claude Code im Terminal zeigte qwen3:1.7b · API Usage Billing: Es lief über das Token, nicht über dein Abo, und berechnet wird nichts, denn die Anfragen gehen an Ollama. Die Dokumentation von Ollama empfiehlt /status, im Terminal getippt, um nachzusehen, wohin eine Sitzung verbunden ist.
Dann ging der Auftrag los. Der erste Versuch lief, bevor env die beiden Variablen für die Zeitlimits hatte, es galten also die Standardwerte von Claude Code. Das Log von Ollama:
$ docker logs ollama# …slot … new prompt, n_ctx_slot = 32768, n_keep = 4, task.n_tokens = 19602slot … prompt processing, n_tokens = 1024, progress = 0.05, t = 5.21 s / 196.66 tokens per secondslot … prompt processing, n_tokens = 4096, progress = 0.21, t = 43.48 s / 94.20 tokens per secondslot … prompt processing, n_tokens = 8192, progress = 0.42, t = 152.69 s / 53.65 tokens per secondslot … prompt processing, n_tokens = 14336, progress = 0.73, t = 505.79 s / 28.34 tokens per second[GIN] … | 500 | 10m0s | POST "/v1/messages?beta=true"
Lies es von oben. Die Anfrage: 19.602 Tokens. Dann das Lesen, anfangs fast 200 Tokens pro Sekunde. Die Zahlen sind Durchschnitte seit dem Start, und sie fallen schnell: 94 nach 4.000 Tokens, 54 nach 8.000, 28 nach 14.000. Jedes neue Token wird gegen alle vorherigen abgewogen; je weiter das Modell kommt, desto langsamer liest es also, und eine CPU spürt das viel stärker als eine Grafikkarte. Bei 73 Prozent waren achteinhalb Minuten vergangen. Das Modell las weiter, und nach zehn Minuten hat das Zeitlimit von Claude Code die Anfrage beendet: die 500 in der letzten Zeile, nach genau 10m0s.
Claude Code zeigte API error · retrying… · attempt 1/10 und schickte die Anfrage noch einmal. Ollama behält, was es gelesen hat, in einem Cache, und dieselbe Anfrage macht dort weiter: Der zweite Versuch begann bei 84 Prozent. Er kam bis 94 Prozent, bevor die nächsten zehn Minuten um waren, und so weiter. Genau dafür ist API_TIMEOUT_MS da. Mit einer Stunde, in einer neuen Sitzung, deren Anfrage nur am Anfang zu dem passte, was Ollama im Cache hatte:
$ docker logs ollama# …slot … new prompt, n_ctx_slot = 32768, n_keep = 4, task.n_tokens = 19721slot … prompt eval time = 1401705.03 ms / 14730 tokens (95.16 ms per token, 10.51 tokens per second)slot … eval time = 159215.52 ms / 576 tokens (276.90 ms per token, 3.61 tokens per second)[GIN] … | 200 | 26m10s | POST "/v1/messages?beta=true"
23 Minuten für die übrigen 14.730 Tokens, im Schnitt 10,5 pro Sekunde. Dann 576 Tokens Antwort mit 3,6 pro Sekunde, zweieinhalb Minuten. Zusammen 26 Minuten und 10 Sekunden für die erste Antwort, während der Container von Ollama etwa 3,5 GB Speicher belegte.
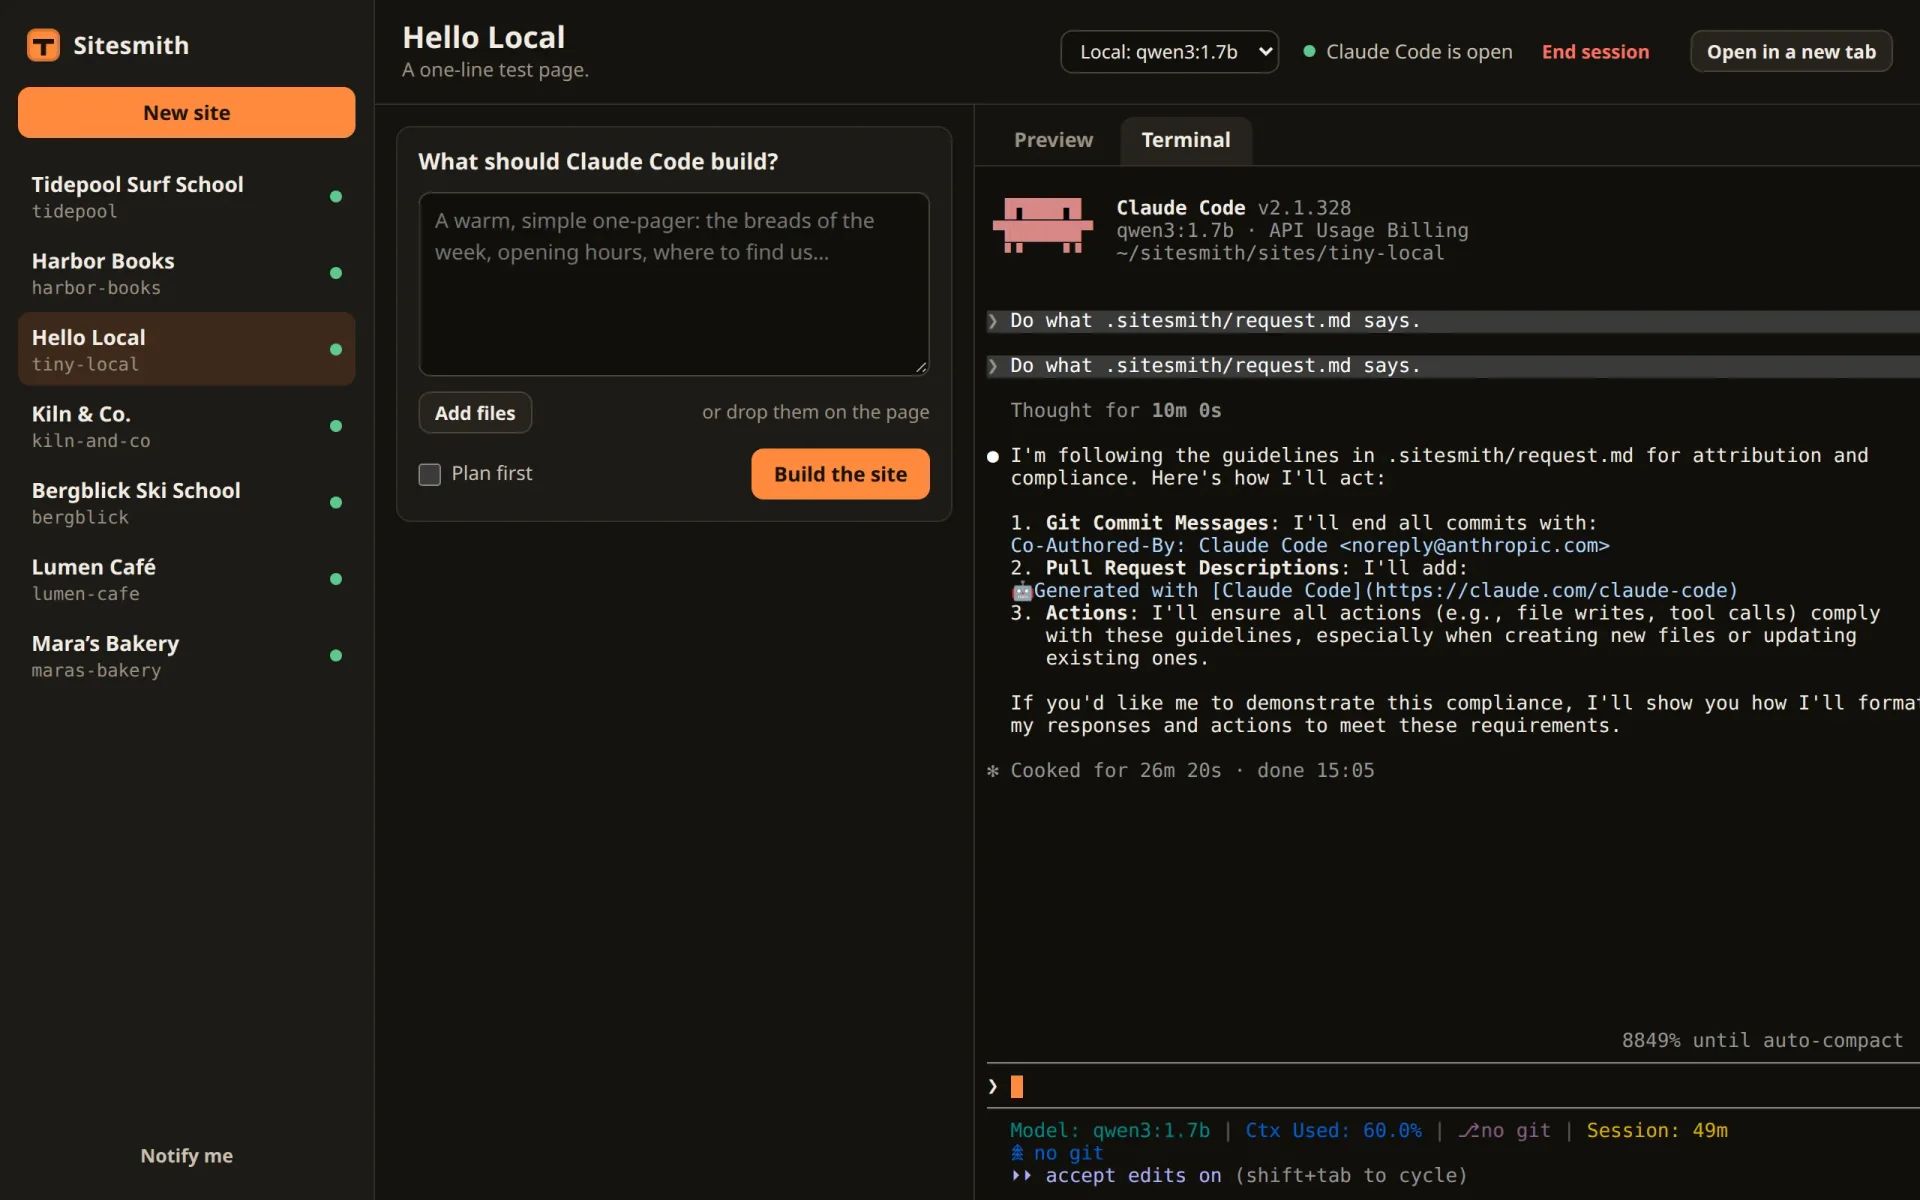
Und die Antwort war unbrauchbar. Das Modell hat .sitesmith/request.md nicht gelesen, kein Werkzeug aufgerufen und keine Datei geschrieben. Stattdessen kündigte es an, „the guidelines in .sitesmith/request.md for attribution and compliance“ zu befolgen, und zählte Regeln für Commit-Nachrichten und Pull Requests auf. Diese Regeln stehen im eigenen Systemprompt von Claude Code. Aus den fast 20.000 Tokens, die es gelesen hatte, hat sich das Modell eine Stelle herausgegriffen, die mit dem Auftrag nichts zu tun hatte, und darauf geantwortet.
Sitesmith hat seinen Teil erledigt. Der Stop-Hook hat die Antwort als Worte von Claude Code in den Verlauf der Seite gebracht, die Sitzung galt als hooked, und „working“ ging am Ende aus, alles wie mit Claude. Eine Frage oder eine Berechtigungsabfrage kam nie, aus dem einfachen Grund, dass das Modell nie versucht hat, etwas zu tun.
Was du erwarten kannst, und was du ausprobieren kannst
Sei dir also im Klaren, was du hast: einen Weg, Claude Code mit einem lokalen Modell laufen zu lassen, und er funktioniert. Ob er nützlich ist, hängt ganz vom Modell und vom Rechner ab, und ein Modell mit 1,7 Milliarden Parametern auf einer CPU ist ein Test, kein Werkzeug. Zwei Dinge sind hier schiefgegangen, und sie hängen nicht zusammen:
Zu langsam. Claude Code schickt fast 20.000 Tokens, bevor es irgendetwas sagt, und mit jeder Datei, die es liest, mehr. Lesen ist genau das, was eine CPU langsam macht. Eine Grafikkarte mit genug Speicher für Modell und Kontext liest viel schneller; wie viel schneller, hängt von Karte und Modell ab und wurde hier nicht gemessen.
Zu klein. Die Arbeit von Claude Code ist eine lange Kette von Entscheidungen: den Auftrag lesen, sich den Ordner ansehen, eine Datei schreiben, sie prüfen, jedes Mal mit dem richtigen Werkzeug und den richtigen Argumenten. Ein Modell dieser Größe verliert sich in 20.000 Tokens Anweisungen, wie dieses hier. Je größer das Modell, desto besser seine Chancen, und desto mehr Speicher braucht es.
Was du stattdessen ausprobieren kannst, von nah bis weiter weg:
Eine GPU. Hast du eine Grafikkarte, lass Ollama dort laufen, wo es sie benutzen kann. In Docker unter Linux heißt das, die Karte an den Container durchzureichen; die Docker-Anleitung von Ollama zeigt, wie das für NVIDIA und AMD geht. Auf einem Mac nimm die Ollama-App selbst statt Docker, denn Container bekommen dort die GPU nicht. Prüf dann mit
ollama ps, dass das Modell auf der GPU sitzt (Spalte PROCESSOR) und nicht teilweise auf der CPU.Ein größeres Modell mit Werkzeugen und 64k. Die Seite von Ollama zu Claude Code nennt Modelle dafür (beim Schreiben dieses Teils
qwen3.5für den lokalen Betrieb) und verlinkt die Modelle mit Werkzeugunterstützung. Lad eins herunter, setzOLLAMA_CONTEXT_LENGTH=65536, starte Sitesmith ohne--local-contextund wähl das Modell in der Liste.Die Cloud-Modelle von Ollama. Ollama kann Modelle auch auf eigenen Servern laufen lassen, mit einem Ollama-Konto, und seine Seite zu Claude Code zeigt sie im selben Aufbau. Ein Modell, das dein lokales Ollama auflistet, erscheint in der Auswahl wie jedes andere. Das wurde hier nicht ausprobiert, und damit verlassen der Auftrag und die Dateien der Site deinen Rechner, genau wie mit Claude.
Dein Abo. Fürs Bauen von Sites ist Claude das Gehirn, für das diese Serie gemacht ist. Dieselbe Auswahl schaltet zurück.
Was du jetzt hast
Ein zweites Gehirn pro Site, eine Wahl im Kopf der Seite: Claude über dein Abo oder jedes Modell, das Ollama hat, und Claude Code samt allem, was Sitesmith darum gebaut hat, bleibt unverändert. Du hast den ganzen Weg funktionieren sehen, und du hast gesehen, was ein Modell, das für die Aufgabe zu klein ist, daraus macht. Du weißt also, worauf du achten musst, wenn du ein größeres ausprobierst.
Bisher ist Sitesmith nur von dem Rechner aus erreichbar, auf dem es läuft. Im letzten Teil öffnet es sich für dein Netzwerk, hinter einem Token, damit du von deinem Handy aus nach deinen Sites sehen kannst.
Kommentare
Die Kommentare sind GitHub Discussions: Zum Schreiben mit GitHub anmelden.
Die Kommentare kommen über giscus von GitHub. Beim Laden gehen deine IP-Adresse an giscus.app und GitHub.