
End-to-End-Tests mit Playwright: Frontend, Backend und Datenbank · Teil 4 von 14 der Serie
Teil 4: Eine Datenbank für jeden Worker
Gib jedem parallelen Worker eine eigene Kopie der Datenbank, erzeugt aus einem Template, das die echten Migrationen bauen, und jedem Test leere Tabellen. Dann laufen die Tests parallel und in beliebiger Reihenfolge, und deine Entwicklungsdaten bleiben unberührt.
End-to-End-Tests mit Playwright: Frontend, Backend und DatenbankTeil 4 von 14
Auf dieser Seite
Quest-Ziele
- Verstehen, was ein Worker ist und warum parallele Tests eigene Daten brauchen
- In einem Setup-Projekt eine Template-Datenbank mit den echten Migrationen der App bauen
- Mit test.extend eigene Fixtures schreiben, eine pro Worker und eine pro Test
- Das Template für jeden Worker kopieren und vor jedem Test die Tabellen leeren
- Zeigen, dass die Tests auf drei Workern und auf einem einzigen bestehen
Seit dem letzten Teil hat die Suite ihre vier Bereiche, aber drei davon arbeiten noch auf deiner Entwicklungsdatenbank. Teil 2 hat gezeigt, wohin das führt: zu einem Test, der grün war, weil ein früherer Lauf etwas liegen gelassen hatte.
Dieser Teil löst die Datenbank-Hälfte dieses Problems. Jeder Worker bekommt eine eigene Datenbank, jeder Test beginnt mit leeren Tabellen, und die Tests des Bereichs database rühren deine Entwicklungsdaten nie wieder an. Die andere Hälfte, der gemeinsame Server, folgt in Teil 6.
Worker, und was sie nicht teilen dürfen
Playwright führt deine Tests nicht nacheinander in einem einzigen Prozess aus. Es startet mehrere Worker: eigene Prozesse, die sich Tests aus der Warteschlange nehmen und sie ausführen, einen nach dem anderen. Die Zeile Running 5 tests using 4 workers im letzten Teil hat das gesagt. Worker sind der Grund, warum eine große Suite in Sekunden fertig ist.
Sie sind auch der Grund, warum gemeinsame Daten wehtun. Schreiben zwei Worker im selben Moment in dieselbe Tabelle, bekommt ein Test, der die Quests zählt, eine Zahl, die davon abhängt, was sein Nachbar gerade tut. So ein Test schlägt ab und zu fehl, und selten dann, wenn du zusiehst.
Der Plan hat drei Schritte:
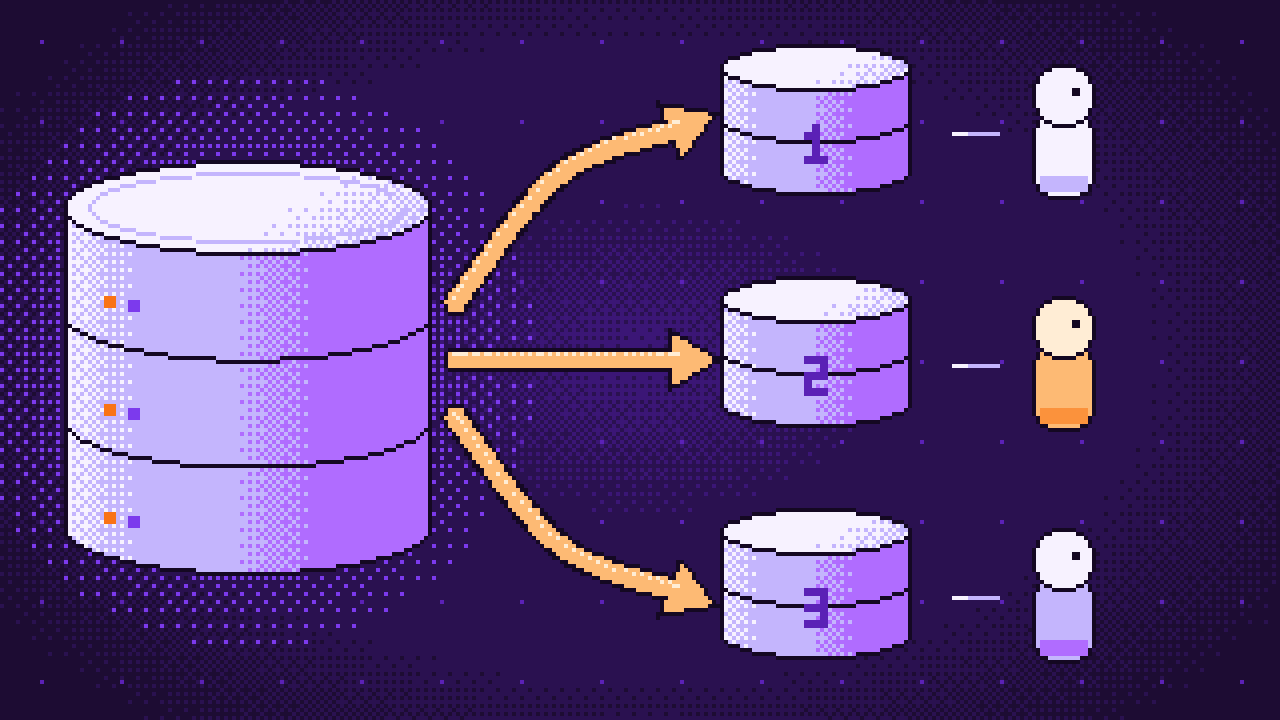
Einmal pro Lauf baut ein Setup-Schritt eine Template-Datenbank namens
questboard_template, mit den echten Migrationen der App.Einmal pro Worker wird das Template in eine Datenbank kopiert, die nur diesem Worker gehört:
questboard_test_0,questboard_test_1und so weiter. PostgreSQL erledigt das mit einer Anweisung,create database … template …, und es dauert Millisekunden.Vor jedem Test werden die Tabellen in der Datenbank des Workers geleert.
Die Kopien halten die Worker auseinander, und das Leeren hält die Tests eines Workers auseinander. Zusammen sorgen sie dafür, dass die Tests parallel und in beliebiger Reihenfolge laufen können.
Die Template-Datenbank
Zwei kleine Funktionen kümmern sich um Datenbanken als Ganzes. Leg tests/support/databases.ts an:
import pg from 'pg';

/** Every worker's database is a copy of this one. */
export const TEMPLATE = 'questboard_template';

/** The address of another database on the server that DATABASE_URL points to. */
export function databaseUrl(name: string) {
  const url = new URL(process.env.DATABASE_URL!);
  url.pathname = `/${name}`;
  return url.href;
}

/**
 * Runs statements that create or drop whole databases. They need a connection that is not
 * inside one of those databases, so this one goes to "postgres", which every server has.
 */
export async function onServer(...statements: string[]) {
  const client = new pg.Client({ connectionString: databaseUrl('postgres') });
  await client.connect();
  try {
    for (const statement of statements) await client.query(statement);
  } finally {
    await client.end();
  }
}
databaseUrl nimmt die Adresse aus deiner .env und tauscht ihr letztes Stück, den Namen der Datenbank, gegen einen anderen. Server, Benutzer und Passwort bleiben, wie sie sind. Die Konfiguration lädt die .env seit Teil 3, DATABASE_URL ist also da, wenn die Tests laufen.
onServer führt Anweisungen aus, die ganze Datenbanken anlegen oder löschen. Eine Datenbank, mit der du verbunden bist, kannst du nicht löschen, und mit einer, die erst entstehen soll, kannst du dich gar nicht verbinden. Diese Anweisungen brauchen also eine Verbindung an eine andere Stelle. Das ist die Datenbank postgres, die jeder Server hat. Die Funktion verbindet sich mit ihr, führt ihre Anweisungen der Reihe nach aus und schließt die Verbindung wieder, auch wenn eine Anweisung fehlschlägt: Dafür ist das finally da.
Irgendetwas muss das Template bauen, bevor der erste Test es braucht. In Playwright ist so ein Schritt ein gewöhnlicher Test in einem eigenen Projekt. Leg tests/setup/database.setup.ts an:
import { test as setup } from '@playwright/test';
import { migrate } from 'drizzle-orm/node-postgres/migrator';
import { connect } from '../../server/db/client.ts';
import { TEMPLATE, databaseUrl, onServer } from '../support/databases.ts';

setup('build the template database', async () => {
  await onServer(
    `drop database if exists ${TEMPLATE} with (force)`,
    `create database ${TEMPLATE}`,
  );

  // The same migrations the app runs, from the first to the last.
  const { db, pool } = connect(databaseUrl(TEMPLATE));
  await migrate(db, { migrationsFolder: './drizzle' });
  await pool.end();
});
Der Import benennt test in setup um, damit sich die Datei als das liest, was sie ist. Zuerst wird das Template des letzten Laufs gelöscht und ein leeres angelegt. with (force) beendet Verbindungen, die zum alten noch offen sind. Ohne diesen Zusatz ließe eine einzige offene Verbindung das Löschen scheitern.
Dann kommen die Migrationen: derselbe Aufruf von migrate mit demselben Ordner drizzle/ wie in server/db/migrate.ts aus Teil 1. Die Tests arbeiten also auf den Tabellen, die deine Migrationen wirklich bauen, nicht auf einer zweiten Beschreibung davon. Hier zahlt sich aus, dass connect(url) die Adresse als Parameter nimmt: Dieselbe Funktion öffnet jetzt das Template statt der Entwicklungsdatenbank.
pool.end() ist mehr als Ordnungsliebe. PostgreSQL kopiert eine Datenbank nur, solange sonst niemand mit ihr verbunden ist. Das Setup muss das Template also loslassen, bevor die Worker kommen.
Jetzt muss die Konfiguration davon erfahren. Füg vor den anderen ein Projekt setup ein und lass database davon abhängen:
{
  name: 'setup',
  testDir: './tests/setup',
  testMatch: /.*\.setup\.ts/,
},
{
  name: 'database',
  testDir: './tests/database',
  dependencies: ['setup'],
},
Von sich aus hält Playwright nur Dateien mit Namen wie board.spec.ts oder board.test.ts für Tests. testMatch sagt diesem Projekt, dass es die Dateien nehmen soll, die auf .setup.ts enden.
dependencies regelt die Reihenfolge. Immer wenn database läuft, führt Playwright zuerst setup aus und wartet darauf, auch wenn du mit --project=database nur ein Projekt verlangst. Schlägt das Setup fehl, werden die Tests, die davon abhängen, gar nicht gestartet.
Eine weitere Zeile kommt oben in die Konfiguration: fullyParallel. Das ist jetzt die ganze Datei:
import { existsSync } from 'node:fs';
import { defineConfig, devices } from '@playwright/test';

// The tests read the same settings as the app. Where there is no .env, such as in a
// pipeline, the variables are set from outside.
if (existsSync('.env')) process.loadEnvFile();

const api = 'http://localhost:3000';
const web = 'http://localhost:5173';

export default defineConfig({
  fullyParallel: true,
  reporter: [['list'], ['html']],
  use: {
    trace: 'on-first-retry',
  },
  projects: [
    {
      name: 'setup',
      testDir: './tests/setup',
      testMatch: /.*\.setup\.ts/,
    },
    {
      name: 'database',
      testDir: './tests/database',
      dependencies: ['setup'],
    },
    {
      name: 'backend',
      testDir: './tests/backend',
      use: { baseURL: api },
    },
    {
      name: 'frontend',
      testDir: './tests/frontend',
      use: { ...devices['Desktop Chrome'], baseURL: web },
    },
    {
      name: 'e2e',
      testDir: './tests/e2e',
      use: { ...devices['Desktop Chrome'], baseURL: web },
    },
  ],
  // Playwright starts both servers before the tests and stops them afterwards.
  webServer: [
    {
      command: 'npm run dev:api',
      url: `${api}/api/health`,
      reuseExistingServer: !process.env.CI,
    },
    {
      command: 'npm run dev:web',
      url: web,
      reuseExistingServer: !process.env.CI,
    },
  ],
});
Ohne fullyParallel führt Playwright Testdateien parallel aus, die Tests innerhalb einer Datei aber nacheinander im selben Worker. Mit dieser Zeile dürfen auch die Tests einer einzelnen Datei auf verschiedene Worker verteilt werden. Das ist schneller, und es funktioniert nur, wenn sich kein Test auf den über ihm verlässt. Genau dafür sorgt der Rest dieses Teils.
Eine Fixture pro Worker, ein Reset pro Test
Zwei Fixtures hast du schon verwendet: page in Teil 2 und request in Teil 3. Eine Fixture ist ein benanntes Ding, das ein Test in seinen Argumenten verlangt. Playwright baut sie vor dem Test und räumt sie danach wieder weg, und für einen Test, der sie nicht verlangt, wird sie gar nicht erst gebaut.
Du kannst eigene Fixtures hinzufügen, und jede hat einen Scope. Eine Fixture mit dem Scope test, dem Standard, wird für jeden Test frisch gebaut. Eine Fixture mit dem Scope worker wird einmal pro Worker-Prozess gebaut, und alle Tests, die darin laufen, teilen sie sich. Das ist das Paar, das der Plan braucht: die Datenbank pro Worker, das Leeren pro Test. Leg tests/fixtures.ts an:
import { test as base } from '@playwright/test';
import { sql } from 'drizzle-orm';
import { connect, type Db } from '../server/db/client.ts';
import { TEMPLATE, databaseUrl, onServer } from './support/databases.ts';

type TestFixtures = {
  /** This worker's database, with empty tables. */
  db: Db;
};

type WorkerFixtures = {
  workerDb: Db;
};

export const test = base.extend<TestFixtures, WorkerFixtures>({
  // Once per worker: a database of its own, copied from the template.
  workerDb: [
    async ({}, use, workerInfo) => {
      const name = `questboard_test_${workerInfo.parallelIndex}`;
      await onServer(
        `drop database if exists ${name} with (force)`,
        `create database ${name} template ${TEMPLATE}`,
      );
      const { db, pool } = connect(databaseUrl(name));

      await use(db);

      await pool.end();
      await onServer(`drop database ${name}`);
    },
    { scope: 'worker' },
  ],

  // Before every test: empty the tables, so no test sees what another one left behind.
  db: async ({ workerDb }, use) => {
    await workerDb.execute(sql`truncate quests restart identity`);
    await use(workerDb);
  },
});

export { expect } from '@playwright/test';
base.extend nimmt Playwrights eigenes test und gibt eines zurück, das mehr Fixtures kennt. Die beiden Typparameter zählen sie auf: zuerst die Fixtures pro Test, dann die pro Worker.
workerDb ist die Datenbank des Workers. Eine Fixture mit Optionen wird als Paar geschrieben: zuerst die Funktion, dann die Optionen, hier { scope: 'worker' }. Die Funktion bekommt drei Argumente. Das erste nennt die Fixtures, die diese hier braucht. Sie braucht keine, und das leere {} ist die Schreibweise, die Playwright dafür verlangt, weil es die Namen aus diesem Muster liest. Das zweite ist use, das dritte beschreibt den Worker.
Der Name der Datenbank endet auf workerInfo.parallelIndex: 0, 1, 2 und so weiter, eine Nummer für jeden Worker, der gleichzeitig läuft. Schlägt ein Test fehl, ersetzt Playwright seinen Worker durch einen frischen, und der übernimmt dieselbe Nummer. Die erste Anweisung löscht eine Datenbank dieses Namens, falls es eine gibt, ein Überbleibsel eines abgestürzten Laufs. Die zweite legt sie als Kopie des Templates an.
await use(db) ist die Mitte jeder Fixture. Was davor steht, ist die Vorbereitung. Dann laufen die Tests, bei einer Worker-Fixture alle Tests dieses Workers. Was danach steht, ist das Aufräumen: Die Verbindungen werden geschlossen und die Datenbank wird gelöscht, ein Lauf, der normal endet, lässt also nur das Template zurück.
db ist das, was die Tests verlangen. Sie nennt workerDb in ihrem ersten Argument, also baut Playwright diese zuerst und reicht sie hinein. Als Test-Fixture läuft db vor jedem Test, der sie verlangt: truncate leert die Tabelle, und restart identity setzt den Zähler der IDs zurück, sodass die erste Quest jedes Tests die ID 1 bekommt. Dann reicht sie die Datenbank des Workers weiter.
Die letzte Zeile reicht expect durch. Ab jetzt importieren Tests, die die Datenbank brauchen, test und expect aus ../fixtures.ts statt aus @playwright/test.
Die Isolation bei der Arbeit sehen
Der Datenbank-Test aus Teil 3 hat die Entwicklungsdatenbank gelesen. Entferne ihn:
$ rm tests/database/connection.spec.tsAn seine Stelle treten drei Tests, die nur bestehen, wenn die Isolation funktioniert. Leg tests/database/isolation.spec.ts an:
import { quests } from '../../server/db/schema.ts';
import { expect, test } from '../fixtures.ts';

test('starts with an empty table', async ({ db }) => {
  expect(await db.select().from(quests)).toEqual([]);
});

test('can add a quest', async ({ db }) => {
  await db.insert(quests).values({ title: 'Find the lost sword' });

  expect(await db.select().from(quests)).toHaveLength(1);
});

test('does not see the quests of other tests', async ({ db }) => {
  await db.insert(quests).values({ title: 'Feed the dragon' });

  const rows = await db.select().from(quests);

  expect(rows.map((quest) => quest.title)).toEqual(['Feed the dragon']);
  // Even the counter of the ids starts over.
  expect(rows[0].id).toBe(1);
});
Jeder von ihnen wäre in einer gemeinsamen Datenbank falsch. Der erste erwartet eine leere Tabelle, der zweite genau eine Zeile, und der dritte nur seine eigene Quest, noch dazu mit der ID 1. In welcher Reihenfolge und in wie vielen Workern sie auch laufen, jeder muss die Tabelle so vorfinden, als wäre er allein.
$ npm run test:database> questboard@1.0.0 test:database> playwright test --project=databaseRunning 4 tests using 3 workers ✓ 1 [setup] › tests/setup/database.setup.ts:6:1 › build the template database (357ms) ✓ 3 [database] › tests/database/isolation.spec.ts:4:1 › starts with an empty table (23ms) ✓ 2 [database] › tests/database/isolation.spec.ts:8:1 › can add a quest (27ms) ✓ 4 [database] › tests/database/isolation.spec.ts:14:1 › does not see the quests of other tests (27ms) 4 passed (3.4s)
Running 4 tests: Das Setup zählt als einer, und es lief zuerst, wie die Abhängigkeit es verlangt. Das Template zu bauen hat den Bruchteil einer Sekunde gedauert. using 3 workers: Wegen fullyParallel gingen die drei Tests dieser einen Datei an drei Worker, und jeder Worker hat das Template in eine eigene Datenbank kopiert.
Drei Tests in drei Datenbanken können einander nicht in die Quere kommen. Der schwierigere Fall ist ein einziger Worker, bei dem alle drei dieselbe Datenbank verwenden, einer nach dem anderen:
$ npx playwright test --project=database --workers=1Running 4 tests using 1 worker ✓ 1 [setup] › tests/setup/database.setup.ts:6:1 › build the template database (126ms) ✓ 2 [database] › tests/database/isolation.spec.ts:4:1 › starts with an empty table (21ms) ✓ 3 [database] › tests/database/isolation.spec.ts:8:1 › can add a quest (12ms) ✓ 4 [database] › tests/database/isolation.spec.ts:14:1 › does not see the quests of other tests (13ms) 4 passed (3.1s)
Dasselbe Ergebnis. Hier hält sie nur das Leeren vor jedem Test auseinander: „can add a quest“ hat eine Zeile hinterlassen, und „does not see the quests of other tests“ hat trotzdem nichts als seine eigene Quest gefunden, mit der ID 1. Führ beide Befehle aus, so oft du willst. Das Ergebnis hängt nicht mehr vom Lauf davor ab, und das ist der Unterschied zu Teil 2.
Was du jetzt hast
Eine Template-Datenbank, die jeder Lauf aus deinen echten Migrationen baut, eine Kopie davon für jeden Worker, und leere Tabellen vor jedem Test. Die Tests des Bereichs database laufen parallel und in beliebiger Reihenfolge, und sie lassen deine Entwicklungsdatenbank in Ruhe.
Die Bereiche backend und e2e nutzen davon noch nichts: Sie sprechen weiterhin mit dem einen Entwicklungsserver. Sie sind in den Teilen 6 und 8 an der Reihe. Im nächsten Teil nutzt du die saubere Datenbank erst einmal für das, wofür sie am besten taugt: die Datenbank selbst zu testen, mit ihren Constraints, ihren Abfragen und ihren Migrationen.
Kommentare
Die Kommentare sind GitHub Discussions: Zum Schreiben mit GitHub anmelden.
Die Kommentare kommen über giscus von GitHub. Beim Laden gehen deine IP-Adresse an giscus.app und GitHub.